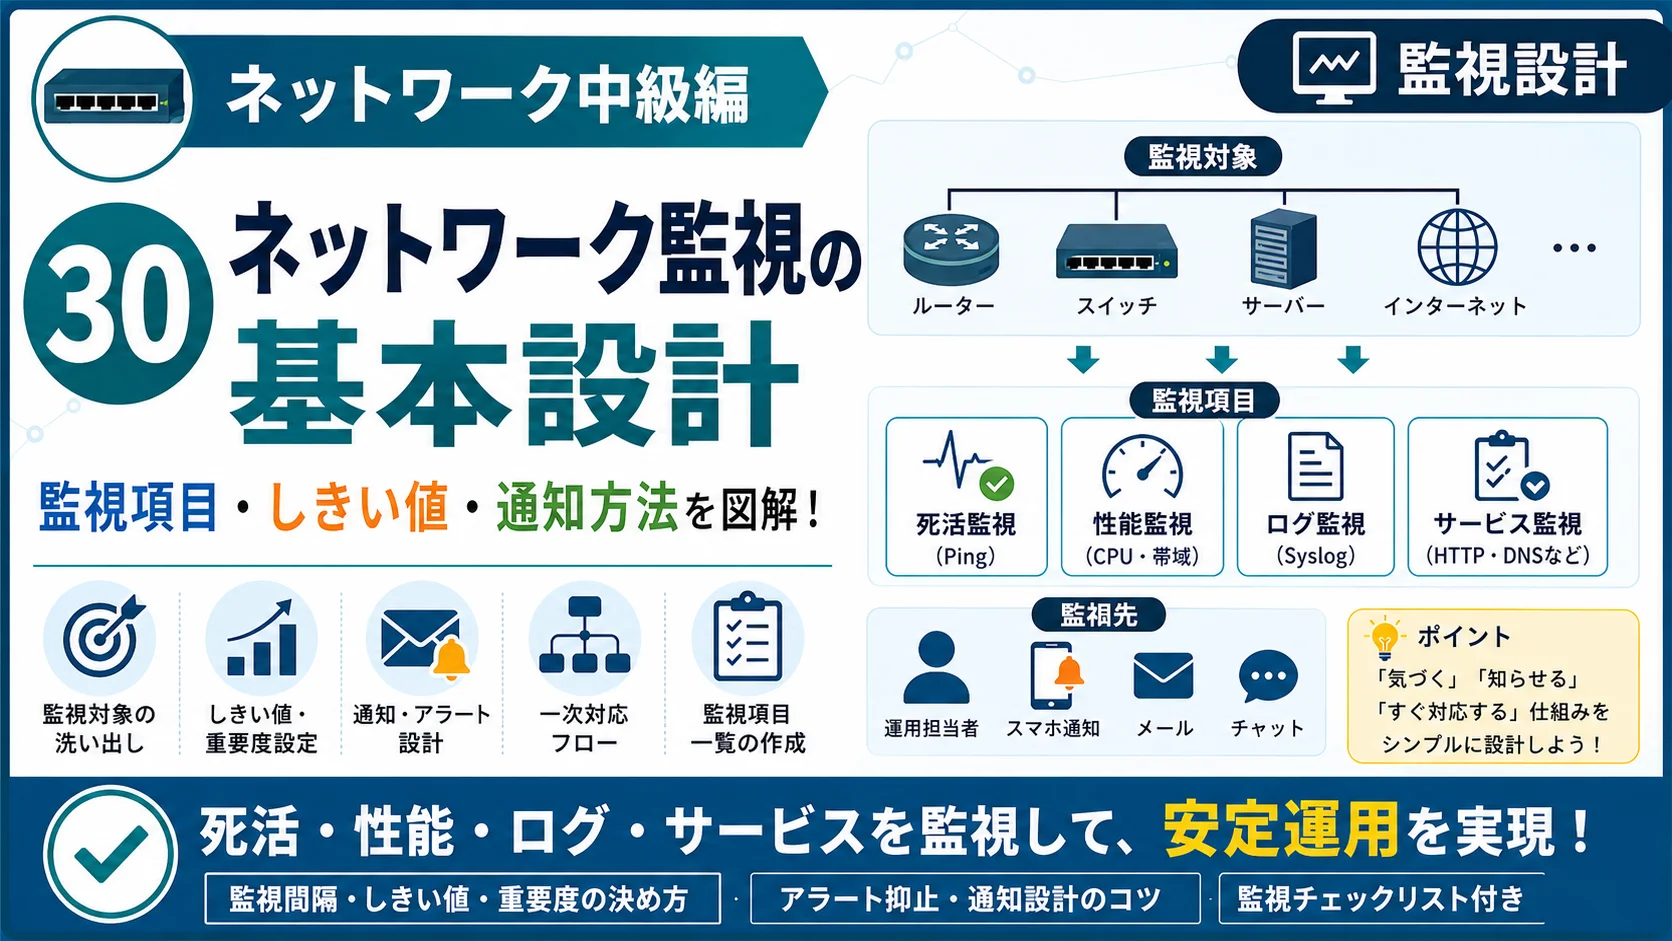
この記事は、 「ネットワーク中級編|構築・検証・障害切り分けを身につける」 の第30回です。
前回学んだNTP・Syslog・SNMPを、実際の監視項目、しきい値、通知、一次対応へ落とし込む方法を学びます。
ネットワーク監視の基本設計とは?監視項目・しきい値・通知方法を図解
監視ツールへ機器を登録するだけでは、適切なネットワーク監視にはなりません。 何を、どの方法で、何分ごとに確認し、どの状態を異常と判断して、誰へ通知するのかを事前に決める必要があります。 この記事では、死活・インターフェース・性能・ログ・サービス監視を整理し、実務で使える監視項目一覧へ落とし込む手順を解説します。
ネットワーク監視でありがちな失敗は、 「監視できる項目をすべて登録する」ことから始めてしまうことです。 項目が多すぎるとアラートが大量に発生し、本当に対応すべき異常が埋もれます。
監視設計では、機器の数より先に、 業務への影響、検知したい異常、異常時に取る行動を整理します。 監視は「見る仕組み」ではなく、「異常を検知して対応へつなげる仕組み」です。
この記事を読み終えるとできること
- ネットワーク監視設計の目的を説明できる
- 死活・状態・性能・ログ・サービス監視を区別できる
- 監視項目、間隔、しきい値、重要度を整理できる
- ポーリングとイベント通知を使い分けられる
- 大量アラートを防ぐ抑止・依存関係を説明できる
- 小規模ネットワークの監視項目一覧を作成できる
ネットワーク監視の基本設計とは
ネットワーク監視の基本設計とは、監視対象、監視項目、取得方法、判定条件、通知先、対応方法を整理し、異常検知から復旧確認までの運用を決めることです。
監視ツールには、Zabbix、PRTG、SolarWinds、Nagios、Prometheusなど、さまざまな製品があります。 しかし、製品が変わっても設計で考える内容は大きく変わりません。
たとえば、ルーターを監視するときには、最低でも次の内容を決めます。
- ルーター自体が応答しているか
- WANインターフェースがUpか
- 通信量やエラーが増えていないか
- CPU・メモリー・温度に異常がないか
- 再起動、リンクダウン、認証失敗などのログが出ていないか
- 異常を何回連続で検知したら通知するか
- 業務時間外は誰へ通知するか
- 復旧時にも通知するか
- 通知を受けた担当者が最初に何を確認するか
監視項目は、異常時の行動とセットで決めます。
アラートを受けても誰も判断できず、何も行動できない項目は、設計を見直す必要があります。
監視の全体像
ネットワーク監視は、機器から情報を集めるだけでは完了しません。 収集、判定、通知、対応、復旧確認までを一つの流れとして設計します。
監視対象から障害対応までの流れ
「検知できる」だけでは不十分
監視サーバーがリンクダウンを検知しても、通知先が未設定なら対応は始まりません。 通知先が決まっていても、対象ポートの用途が分からなければ影響を判断できません。
したがって、監視項目には技術情報だけでなく、次の運用情報も必要です。
- 対象機器・インターフェースの役割
- 利用部門・業務・システム
- 障害時の影響範囲
- 運用担当、保守ベンダー、回線事業者
- 一次対応手順とエスカレーション条件
監視項目を5つに分ける
監視項目は、次の5つへ分けると漏れや重複を整理しやすくなります。
死活監視
機器やIPアドレスから応答があるかを確認します。代表例はICMP Echoによるping監視です。
- ルーター・スイッチの応答有無
- 監視サーバーからの到達性
- 応答時間・パケットロス
状態監視
機器内部の状態や、インターフェース・電源・温度などを確認します。
- インターフェースUp/Down
- 電源・ファン・温度
- 冗長系の状態
- OSPF・BGP・VPNセッション
性能・容量監視
通信品質やリソース使用量の悪化を、停止する前に把握します。
- CPU・メモリー使用率
- インターフェース使用率
- エラー・破棄・パケットロス
- 遅延・ジッター・接続数
ログ監視
Syslogなどからイベントや異常の兆候を検知し、原因調査に使います。
- リンクダウン・再起動
- 設定変更・ログイン失敗
- 認証・VPN・ルーティング異常
- ハードウェア警告
サービス監視
機器が生きているかではなく、利用者が必要なサービスを使えるかを確認します。
- DNS名前解決
- HTTP/HTTPS応答
- DHCPアドレス払い出し
- VPN接続・認証
構成・セキュリティ監視
環境によっては、設定変更や脆弱性、証明書期限なども監視対象にします。
- コンフィグ変更・バックアップ差分
- 証明書有効期限
- 管理者ログイン
- ファームウェア・脆弱性情報
pingが通る=サービス正常ではない
pingへ応答するWebサーバーでも、Webサービスが停止していればページは表示できません。 反対に、セキュリティポリシーでICMPを拒否していても、HTTPSは正常に動作する場合があります。
死活監視だけで「正常」と判断しないことが重要です。 利用者の視点で、必要な通信やサービスまで確認する監視を組み合わせます。
監視方式を使い分ける
監視方式は、大きく「監視サーバーから定期的に取得する方式」と「機器からイベントを送る方式」に分けられます。
ICMP監視
監視サーバーからICMP Echo Requestを送り、応答有無、応答時間、パケットロスを確認します。
- 向いている用途:基本的な死活・到達性
- 注意点:ICMP拒否時やサービス障害は判断できない
SNMP監視
監視サーバーが機器へ定期的に問い合わせ、インターフェース、CPU、メモリー、温度、通信量などを取得します。
- 向いている用途:状態・性能・容量監視
- 注意点:OID、権限、通信量、監視間隔を設計する
SNMP Trap
リンクダウンや機器異常が発生したとき、機器側から監視サーバーへ通知します。
- 向いている用途:即時性が必要な状態変化
- 注意点:通知の欠落を考慮し、ポーリングと併用する
Syslog監視
機器が出力するログを収集し、重要度や文字列、イベントIDなどで判定します。
- 向いている用途:原因調査、設定変更、認証失敗
- 注意点:時刻同期、保存期間、不要ログの除外
サービス監視
DNS問い合わせ、TCPポート接続、HTTP応答、証明書期限など、実際のサービス動作を確認します。
- 向いている用途:業務サービスの利用可否
- 注意点:監視元の場所と確認内容を明確にする
API・エージェント
クラウド管理型機器やコントローラー、サーバーから、APIや専用エージェントで詳細情報を取得します。
- 向いている用途:無線LAN、SD-WAN、クラウドサービス
- 注意点:認証情報、API制限、仕様変更
| 方式 | 情報の流れ | 強み | 弱み・注意点 |
|---|---|---|---|
| ポーリング | 監視サーバー → 対象機器 | 一定間隔で状態を確認でき、通知欠落にも気づきやすい | 間隔より短い瞬間的な異常を見逃すことがある |
| Trap/Syslog | 対象機器 → 監視サーバー | イベント発生時に素早く通知できる | 通信断や設定不備で通知が届かない可能性がある |
| サービス監視 | 監視元 → 実サービス | 利用者に近い視点で正常性を確認できる | 監視元の障害とサービス障害を区別する設計が必要 |
NTPは監視方式ではありませんが、監視基盤の前提です。 機器、監視サーバー、ログサーバーの時刻がずれていると、複数機器のイベントを正しい順番で追えません。
監視項目ごとに決める情報
「CPUを監視する」「リンクダウンを監視する」だけでは、設計情報として不足しています。 監視項目ごとに、少なくとも次の内容を整理します。
対象
機器名、IPアドレス、インターフェース、サービス、拠点を特定します。
項目
死活、リンク状態、CPU、通信量、エラー、ログなどを記載します。
方式
ICMP、SNMPポーリング、Trap、Syslog、HTTPなどを決めます。
取得間隔
30秒、1分、5分など、必要な検知速度と負荷から決めます。
判定条件
しきい値、連続回数、継続時間、復旧条件を定義します。
重要度
情報、警告、重大など、業務影響に応じて分類します。
通知
誰へ、何で、いつ通知するか、再通知やエスカレーションを決めます。
対応
一次確認、影響確認、連絡先、復旧確認、記録方法を決めます。
監視間隔は短いほどよいとは限らない
監視間隔を短くすると、異常を早く検知できます。 一方で、監視サーバー、ネットワーク、対象機器への負荷や、保存データ量が増えます。
| 監視対象の例 | 間隔の例 | 考え方 |
|---|---|---|
| 基幹ルーターの死活 | 30秒~1分 | 業務影響が大きく、早期検知が必要 |
| 重要なWANリンク状態 | 1分+Trap | ポーリングで状態確認し、Trapで即時性を補う |
| 通信量・CPU使用率 | 1~5分 | 傾向確認と異常検知に必要な粒度を選ぶ |
| コンフィグバックアップ | 1日1回・変更時 | 即時性より変更履歴と復旧可能性を重視 |
| 証明書有効期限 | 1日1回 | 期限の数十日前から段階的に通知する |
上表は設計例です。実際の値は、業務要件、保守体制、機器性能、監視製品の仕様、既存運用に合わせて決めます。
しきい値の決め方
しきい値とは、取得した値を正常・警告・重大などへ分類する境界です。 しきい値を固定値だけで決めると、誤検知や見逃しが増えることがあります。
しきい値は「値 × 時間 × 回数」で考える
CPU 0~69%
70%以上が10分継続
90%以上が5分継続
この数値は説明用の例です。機器によってCPUの計測方法や正常範囲が異なるため、ベンダー資料と実測値を確認して調整します。
1.平常時の値を測る
まず、通常時・繁忙時・バックアップ時などの値を一定期間記録し、基準となる状態を把握します。 この基準をベースラインと呼びます。
たとえば、平常時のWAN使用率が常に60~70%の拠点で、70%を警告にすると、毎日アラートが発生します。 反対に、普段5%しか使わない回線が突然60%になった場合は、固定しきい値80%では異常に気づけません。
2.瞬間値ではなく継続時間を見る
CPUや通信量は、処理の開始時に一時的に上がることがあります。 1回だけしきい値を超えた時点で通知すると、不要なアラートが増えます。
- 3回連続でping失敗したら障害
- CPU使用率90%以上が5分続いたら重大
- パケットロス5%以上が3回続いたら警告
- インターフェースDownは即時通知
3.発報条件と復旧条件を分ける
しきい値付近で値が上下すると、障害と復旧が何度も通知されることがあります。 これを防ぐため、発報条件と復旧条件に差を設けます。
例:回線使用率
80%以上が10分続いたら警告、70%未満が10分続いたら復旧、とすると通知の揺れを抑えられます。 このような考え方をヒステリシスと呼びます。
4.累積カウンターは増加量で見る
インターフェースのエラーカウンターは、機器起動後から累積されることがあります。 累積値が100という事実だけでは、現在もエラーが増えているか判断できません。
監視では、前回取得値との差分や単位時間あたりの増加率を確認します。 通信量も、オクテットカウンターの差分からbpsへ換算して利用率を判断します。
重要度・通知・エスカレーション
すべてのイベントを同じ方法で通知すると、重要な障害が埋もれます。 業務影響と緊急度に応じて重要度を分け、通知経路を変えます。
| 重要度 | 状態の例 | 通知例 | 対応目安 |
|---|---|---|---|
| 情報 | 管理者ログイン、設定保存、定期再起動 | 画面・ログへ記録 | 定期確認 |
| 警告 | 高使用率、エラー増加、証明書期限接近 | メール・チャット | 業務時間内に確認 |
| 重大 | 基幹機器停止、重要回線断、冗長系全断 | 電話・オンコール・チケット | 即時対応 |
通知設計で決めること
- 通知先の部署・担当者・オンコール
- メール、チャット、電話、チケットなどの手段
- 平日・休日、昼間・夜間の通知先
- 何分未対応なら再通知するか
- どの条件で上位担当・保守ベンダーへ連絡するか
- 復旧通知を誰へ送るか
- 利用者・顧客へ状況を報告する条件
技術的な重要度と業務上の重要度は一致しない場合があります。
同じポートダウンでも、未使用ポートなら情報、冗長回線の片系なら警告、唯一の基幹回線なら重大になります。
大量アラートを防ぐ設計
監視対象が増えると、一つの障害から多数のアラートが発生することがあります。 この状態を放置すると、担当者が根本原因を見つけにくくなります。
親子関係・依存関係を設定する
拠点WAN回線が停止した場合
WAN回線が停止すると、拠点内のスイッチ、アクセスポイント、サーバーも監視サーバーから見えなくなります。 すべてを個別障害として通知するのではなく、上位経路の障害を優先して表示します。
メンテナンス時間を登録する
計画停止中にアラートが発生すると、不要な通知が大量に送られます。 作業開始前に対象機器・時間帯をメンテナンスモードへ登録し、通知抑止と記録を行います。
同じ障害をまとめる
- 同一イベントの重複通知をまとめる
- 障害継続中は一定間隔で再通知する
- 短時間のDown/Upを一つの事象として扱う
- 冗長構成では片系障害と全系障害を分ける
- 不要な未使用ポートやDebugログを監視対象から外す
通知抑止は「異常を隠す」ことではありません。 画面やログには記録しつつ、担当者へ送る通知を整理する設計です。
小規模オフィスの監視設計例
次の構成を例に、監視項目一覧を作ります。
監視対象となる小規模オフィス
| 対象 | 監視項目 | 方式・間隔 | 判定条件の例 | 重要度・一次対応 |
|---|---|---|---|---|
| FW-01 | 死活 | ICMP・1分 | 3回連続失敗 | 重大・電源、回線、到達経路を確認 |
| FW-01 | WANインターフェース状態 | SNMP・1分+Trap | Downを検知 | 重大・回線障害、物理リンクを確認 |
| FW-01 | WAN使用率 | SNMP・5分 | 80%以上が15分継続 | 警告・利用状況、異常通信を確認 |
| SW-01 | 重要ポート状態 | SNMP・1分+Trap | FW・AP・サーバーポートがDown | 重大または警告・ケーブルと対向機器を確認 |
| SW-01 | CRCエラー・破棄 | SNMP・5分 | 前回値から継続増加 | 警告・ケーブル、速度、輻輳を確認 |
| AP-01 | 死活・接続台数 | ICMP/API・5分 | 応答なし、想定上限超過 | 警告・給電、収容状況を確認 |
| SV-01 | DNS名前解決 | DNS問い合わせ・1分 | 3回連続失敗・応答内容不正 | 重大・DNSサービスと経路を確認 |
| SV-01 | HTTPS応答 | HTTP監視・1分 | 応答なし、異常ステータス、遅延 | 重大・Web、FW、DNSを切り分け |
| 全機器 | 時刻同期・Syslog受信 | NTP/ログ確認・5分 | 同期外れ、一定時間ログなし | 警告・NTP、ログ転送設定を確認 |
「重要ポート」と「未使用ポート」を区別することが実務上の重要ポイントです。 全ポートのDownを通知すると、端末の電源OFFやケーブル抜去まで障害として扱うことになります。
アラートを受けたときの確認順序
- アラート内容を確認する 対象、時刻、監視項目、重要度、継続時間、関連アラートを確認します。
- 業務影響を確認する 利用者、拠点、VLAN、サービス、冗長系の状態から影響範囲を判断します。
- 上位経路から確認する 監視サーバー、回線、ルーター、スイッチ、対象サービスの順に到達性を確認します。
- 状態・ログ・履歴を確認する 現在値だけでなく、直前の変化、Syslog、設定変更、グラフを確認します。
- 一次報告・エスカレーションを行う 発生時刻、影響、確認結果、暫定対応、次の確認事項を整理して連絡します。
- 復旧と再発を確認する アラート復旧だけでなく、利用者視点の通信試験と一定時間の安定性を確認します。
監視設計で作る成果物
監視設定を担当者の記憶だけで運用すると、機器追加や担当変更のたびに品質が変わります。 最低限、次の成果物を残します。
監視対象一覧
機器名、IPアドレス、設置場所、役割、管理部署、保守情報を一覧化します。
監視項目一覧
方式、間隔、しきい値、重要度、復旧条件、通知先、一次対応を項目単位で記載します。
通知・エスカレーション表
重要度、時間帯、一次通知先、再通知時間、上位連絡先を整理します。
監視構成図
監視サーバー、監視経路、ログ転送先、拠点間の依存関係を図にします。
運用手順書
アラート確認、切り分け、連絡、チケット登録、復旧確認の手順を記載します。
監視試験項目書
リンクダウン、しきい値超過、Trap、Syslog、通知、抑止、復旧が想定どおり動くか試験します。
監視項目一覧のテンプレート
No.
拠点名
機器名
管理IPアドレス
監視対象・インターフェース
監視項目
監視方式
取得間隔
警告条件
重大条件
復旧条件
重要度
通知先
通知時間帯
再通知・エスカレーション
一次対応
保管期間
備考
監視項目一覧は、設定表であると同時に、運用の合意書です。 「何を異常とするか」「誰が対応するか」を関係者で合意してから実装します。
ネットワーク監視設計でよくある失敗
機器がICMPへ応答していても、DNS、HTTPS、VPNなどのサービスが停止している場合があります。 重要サービスは実際の通信まで確認します。
未使用ポートや利用者端末ポートまで通知すると、不要なアラートが増えます。 重要リンク、冗長リンク、端末ポートを分類します。
正常範囲や取得値の意味は機種・OSで異なります。ベンダー資料とベースラインを確認し、継続時間も含めて決めます。
機器や経路が停止すると、通知自体が届かない可能性があります。重要項目は定期ポーリングと組み合わせます。
通知を受けた担当者が何を確認するか、どの条件でエスカレーションするかまで決めます。
設定変更、回線増設、冗長化、機器更改と監視設計を同じ変更管理の中で更新します。
検知したい異常、必要な検知速度、通知先、一次対応を先に整理すると、実用的な監視になります。
理解度チェック
記事の内容を確認するため、次の5問に答えてください。 解答を見る前に、自分で理由まで考えてみましょう。
問題1.ネットワーク監視の基本設計で決める内容として、最も不足しているものはどれですか。
「FW-01のCPU使用率をSNMPで5分ごとに取得する」
- 機器名
- 監視方式
- 取得間隔
- 異常判定条件・通知先・一次対応
解答を見る
値を取得するだけでは、何%を異常とするか、誰へ通知するか、何を確認するかが分かりません。
問題2.ping監視が正常なら、Webサービスも必ず正常ですか。
解答を見る
ICMPへ応答していても、Webプロセス停止、TCPポート拒否、証明書異常、アプリケーション障害などが発生している可能性があります。
問題3.WAN回線断により拠点内の20台が応答しなくなりました。大量通知を防ぐために有効な設計はどれですか。
- すべての監視間隔を1秒にする
- 拠点ルーターと配下機器の依存関係を設定する
- 配下機器の監視をすべて削除する
- すべての重要度を情報へ変更する
解答を見る
上位の回線やルーターを親として扱い、親障害時に配下機器の通知を抑止すると、根本原因を把握しやすくなります。
問題4.CPU使用率が一瞬だけ90%になりました。すぐ重大アラートにしないために追加すべき条件は何ですか。
解答を見る
「90%以上が5分継続」「3回連続で超過」などを追加し、瞬間的な上昇による誤検知を抑えます。
問題5.次の空欄を埋めてください。
機器からのTrapやSyslogは即時性に優れますが、通知が届かない可能性もあるため、重要な状態は定期的な( A )と組み合わせます。また、複数機器のログを時系列で調査するため、( B )による時刻同期が必要です。
解答を見る
実践演習:支店ネットワークの監視項目を設計しよう
次の支店ネットワークについて、最低限必要な監視項目を考えてください。
演習用構成
要件
- 支店は平日8:00~20:00に利用する
- WAN回線が停止すると、支店は業務システムを利用できない
- 支店ルーターとスイッチは保守対象
- 利用者PCの電源OFFは通知不要
- 重大障害は運用担当へ即時通知する
- 警告はメールで通知し、翌営業日までに確認する
課題1.監視項目を5つ以上作成する
対象、監視項目、方式、間隔、判定条件、重要度、一次対応を整理してください。
解答例を見る
| 対象 | 項目 | 方式・間隔 | 判定 | 重要度・対応 |
|---|---|---|---|---|
| RT-Branch | 死活 | ICMP・1分 | 3回連続失敗 | 重大・WAN、電源、機器を確認 |
| RT-Branch | WAN状態 | SNMP・1分+Trap | Down | 重大・回線事業者と物理状態を確認 |
| RT-Branch | WAN使用率 | SNMP・5分 | 80%以上が15分 | 警告・トラフィック内訳を確認 |
| SW-Branch | RT・AP接続ポート | SNMP・1分+Trap | Down | 重大または警告・対向とケーブル確認 |
| SW-Branch | エラー・破棄 | SNMP・5分 | 継続増加 | 警告・ケーブル、速度、輻輳を確認 |
| AP-Branch | 死活 | ICMP・5分 | 3回連続失敗 | 警告・PoE、接続ポートを確認 |
| 全機器 | 重要Syslog | イベント受信 | 再起動、温度、認証失敗 | 内容に応じて警告・重大 |
課題2.通知を抑止すべき条件を考える
解答例を見る
RT-Branchを支店内機器の親として設定し、RT-Branchが応答しない間はSW-BranchとAP-Branchの死活通知を抑止します。 画面上には各機器の状態を記録しつつ、担当者へは支店到達不可の代表アラートを通知します。
課題3.一次報告を作成する
9:10に支店WAN回線Downを検知し、支店ルーターも応答しなくなったと仮定します。 原因はまだ確定していません。上司への一次報告を書いてください。
報告例を見る
9:10に支店WANインターフェースのDownを検知し、同時刻から支店ルーターへの疎通も失敗しています。 現時点では支店から本社業務システムを利用できない可能性があります。 本社側監視基盤と他拠点の監視は正常です。支店機器の電源状態および回線事業者側の障害有無を確認中です。 9:30までに確認状況を再報告します。
自分の言葉で説明する課題
「ネットワーク監視は、機器へpingを打つだけでは不十分なのはなぜですか?」と質問されました。 1分程度で説明してください。
説明例を見る
pingで分かるのは、主に監視サーバーから対象IPアドレスへ到達でき、ICMPへ応答していることです。 pingが通っていても、DNSやWeb、VPNなどのサービスが停止している場合があります。 また、通信量の増加、エラー、CPUや温度の異常、設定変更などは、SNMPやSyslogを使わなければ把握できません。 さらに、異常を検知した後に誰へ通知し、何を確認するかまで決めて初めて、監視が障害対応につながります。
まとめ
- 監視設計では、対象、項目、方式、間隔、判定、重要度、通知、対応を決める
- 監視項目は、死活、状態、性能・容量、ログ、サービスへ分けると整理しやすい
- ICMPやSNMPのポーリングと、Trap・Syslogのイベント通知を組み合わせる
- pingが通っていても、業務サービスが正常とは限らない
- しきい値は固定値だけでなく、ベースライン、継続時間、連続回数、復旧条件から決める
- 重要度は技術的な状態ではなく、業務影響を含めて判断する
- 親子関係、メンテナンス、重複排除で大量アラートを防ぐ
- 監視項目一覧、通知表、構成図、運用手順、試験項目書を成果物として残す
良い監視設計とは、すべてを監視することではなく、対応すべき異常を適切な速さで見つけ、担当者が迷わず行動できるようにすることです。
参考資料
- RFC 792:Internet Control Message Protocol
- RFC 3411:Architecture for SNMP Management Frameworks
- RFC 5424:The Syslog Protocol
- RFC 5905:Network Time Protocol Version 4
監視可能な項目、OID、ログ形式、初期値、しきい値の目安は、機種・OS・ライセンス・ソフトウェアバージョンによって異なります。 本番環境へ実装する前に、対象製品と監視ツールの公式ドキュメントを確認してください。
中級編では、スイッチング、ルーティング、セキュリティ、パケット解析、障害切り分けを、 構成例と確認問題を使って順番に学びます。



コメント
コメント一覧 (2件)
[…] ← 前の記事:ネットワーク監視の基本設計 中級編一覧 次:第3章 実践演習 → […]
[…] ← 前の記事:ネットワーク監視の基本設計 中級編一覧 次:第4章 検証とトラブルシューティング → CHAPTER 3 PRACTICAL EXERCISE […]